Derniers Articles
Bing Copilot : un brevet détaille comment les moteurs IA trient les sources web Google Discover retire vos articles avant même de les classer : six réflexes pour les éditeurs. AI Social : une offre d’emploi de Google annonce un partage des réponses IA qui brouille l’attribution SEO Robots.txt et crawlers IA : Google rappelle quelques règles fondamentales Nouvelle formation GEO : Luca Fancello vous apprend à faire citer votre marque par les IA GEO en BtoB : pourquoi l’environnement éditorial devient aussi stratégique que le contenu YouTube, Reddit, TikTok : le suivi de positions ne mesure pas la visibilité sociale dans l’IA, selon Minddex Indexé, mais pas classé, même sur la marque : le point de vue de John Mueller L’édition d’octobre 2026 de Réacteur est en ligne ! Visibilité IA : 194 pros du search dévoilent leurs pratiques SEO et GEOLire l'article complet : Bing Copilot : un brevet détaille comment les moteurs IA trient les sources web
Publié le 26/10/2026 à 14:40:30 par Abondance
Bing Copilot : un brevet détaille comment les moteurs IA trient les sources web
Ce qu'il faut retenir :
- La demande de brevet US20260236548A1, publiée le 13 août 2026 par Microsoft Technology Licensing, décrit un système qui compresse les données issues des résultats de recherche pour les faire tenir dans la limite de tokens d'un modèle génératif.
- Pour résumer une page, le système retient les phrases les plus connectées au reste du texte et à la requête, via un graphe de similarité, et favorise celles placées en introduction ou en conclusion.
- Les contenus sont aussi filtrés selon leur fraîcheur, avec des seuils variables selon le domaine, et selon un score de réputation combinant historique d'exactitude, autorité du domaine et validation par les pairs.
- Pour les rédacteurs, le brevet plaide pour des phrases de synthèse autonomes, des contenus datés et des informations recoupables, sans prouver pour autant que Bing ou Copilot appliquent ce système tel quel.
Microsoft décrit la compression des sources avant l’appel au modèle
Le document s’intitule « Generating and utilizing compressed grounding data for search engines that utilize generative artificial intelligence models ». Il a été publié le 13 août 2026 sous le numéro US20260236548A1, au nom de Microsoft Technology Licensing LLC, et revendique la priorité d’une demande provisoire indienne déposée le 13 février 2025.
Pour rappel, les « grounding data » (données d’ancrage) sont les contenus récupérés dans les résultats de recherche (liens, extraits, métadonnées, réponses directes) que l’on fournit à un modèle de langage pour qu’il fonde sa réponse sur des faits vérifiables. C’est le principe du RAG (retrieval-augmented generation, ou génération augmentée par la récupération).
Le brevet part d’un constat technique. Quand ces données dépassent la limite de tokens du modèle, il faut multiplier les appels, ce qui coûte du temps et des ressources. Et quand on lui en donne trop d’un coup, le modèle produit des réponses généralistes ou incohérentes. Le texte cite deux défauts connus des LLM :
- Lost in the middle : les informations situées au milieu d’un long prompt sont mal prises en compte.
- Biais de récence : le modèle accorde trop de poids aux éléments placés en fin de prompt.
La solution proposée consiste à « compresser » les données d’ancrage avant de les envoyer, de façon à tout faire passer en un seul appel. Deux techniques sont décrites : un résumé centré sur la requête, puis éventuellement une conversion en embeddings (représentations vectorielles du sens d’un texte). Avant cela, le système peut évaluer la fraîcheur et la crédibilité des contenus.
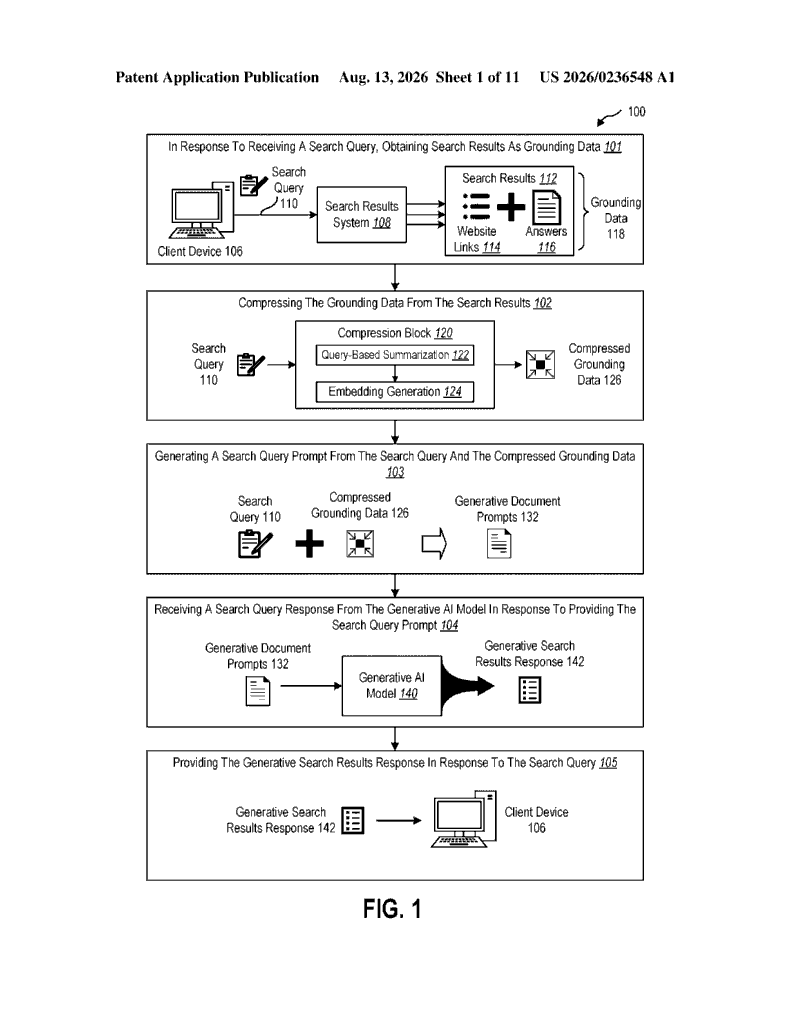
Dans sa publication LinkedIn, Ian Sorin présente ce brevet comme une description du fonctionnement des chatbots de Microsoft, Copilot et Bing. Le texte de la description parle, lui, de « moteurs de recherche génératifs » en général, et cite comme exemples de modèles GPT-3.5, GPT-4 ou GPT-4o, sans nommer Bing ni Copilot.
Les phrases centrales d’un document sont retenues en priorité
La...